作者: admin

  • Apollo3 Blue:Ambiq 超低功耗 AI 开发板

    Apollo3 Blue:Ambiq 超低功耗 AI 开发板

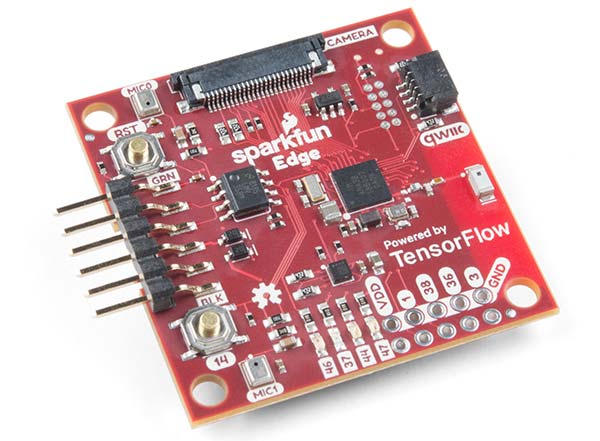
    SparkFun Edge 是 2019 年由 SparkFun、Ambiq、Google 联合推出的一款专为 TensorFlow Lite 入门设计的开发板。它把 Ambiq 当时最新的 Apollo3 Blue SoC、MEMS 麦克风、加速度计、CR2032 电池座、蓝牙天线塞进了一枚30 mm 见方的小板里。

    > 2024 年 SparkFun 已将 Edge 标记为 retired(停产),目前是历史产品。但 Apollo3 Blue SoC 仍然在 Ambiq 产品线里活跃,被用于医疗 / 健康可穿戴产品。

    Apollo3 Blue SoC

    Apollo3 Blue 是 Ambiq Apollo3 家族的一员:

    • CPU:48 MHz Arm Cortex-M4F(带 FPU)+ 96 MHz turboSPOT 模式
    • 功耗:6 μA / MHz(运行)/ 1 μA(深度睡眠)
    • 内存:1 MB Flash + 384 KB SRAM
    • 无线:专用 BLE 5 处理器(与主 CPU 隔离)
    • 外设:6x I2C/SPI 主机、2x UART、1x I2C/SPI 从机、15 通道 14-bit ADC
    • 封装:BGA

    Apollo3 Blue 的杀手锏是运行 TensorFlow Lite 模型——这是当时 Ambiq 跟 Google 合作的卖点,证明 Cortex-M4F 在 6 μA/MHz 的功耗下能跑 1 KB 级别的 TFLite 模型。

    SparkFun Edge 板子构成

    • 尺寸:1.6 × 1.6 × 0.35 inch(40.6 × 40.6 × 8.9 mm)
    • 电池:CR2032 纽扣电池
    • 传感器:

    – 2x MEMS 麦克风 + 运放(75x 增益)
    – ST LIS2DH12 3 轴加速度计
    – OV7670 摄像头接口

    • 无线:板载蓝牙天线(PCB 走线)
    • 扩展:Qwiic I2C 接口 + 4x GPIO + 4x LED + 1x 按钮
    • 编程:FTDI-style UART bootloader + JTAG(JTAG 排针在板子底部)

    TensorFlow Lite 演示

    Edge 出厂带 语音关键词识别 示例:检测 “Yes / No / Stop / Go” 4 个关键词。这个示例由 Google TensorFlow Lite 团队跟 Ambiq 合作开发,模型压到 ~20 KB,可以在 Apollo3 Blue 上实时跑。

    Edge 还演示了 “always-on voice“:用 1 个 MEMS 麦克风 + 6 μA/MHz 的 Cortex-M4F,CR2032 电池可以跑数天到数周(而不是 typical voice assistant 的几小时)。

    历史意义

    Edge 在 TinyML 历史上的位置:

    • 2019 年:Ambiq 第一个与 TensorFlow Lite 官方合作的板子
    • 2019-2020:TinyML 社区的”入门首选板”
    • 2024 年:SparkFun 停产,被 XIAO nRF52840 Sense / nRF54LM20A Sense 等新板取代

    Edge 不是”最好的 TinyML 板”——它把麦克风 / IMU / 电池塞在一枚硬币大小、CR2032 单电池供电的板子上,是当时最低功耗的 voice trigger 板。这一点过去 5 年没人能超越。

    几个观察

    1. Edge 是”教育用板”,不是”产品用 SoC”

    Edge 的目标用户是:

    • 学生 / Maker 想学 TensorFlow Lite
    • 工程师想评估”语音 trigger + 超低功耗”这个组合
    • 早期 TinyML 研究者

    Edge 不是量产产品——CR2032 电池 + 30 mm 板 + 1.6 mm 麦克风间距是 demo 配置。量产可穿戴需要重新设计 PCB、选小尺寸电池、做声学优化。

    Apollo3 Blue 本身是量产 SoC,被用在了医疗 / 健康产品里。

    2. 2019 → 2026:7 年时间,TinyML 板子小一个数量级

    2019 年 SparkFun Edge:30 × 30 mm,CR2032,单 BLE
    2026 年 XIAO nRF54LM20A Sense:21 × 17.8 mm,3.7V 锂电池,BLE 6.0 + Matter + Thread + NPU(LM20B 版)+ IMU + 麦克风

    7 年时间,板子小 ~30%,但功能增加 5-10 倍(多协议、AI、更多传感器、更多 RAM)。这就是摩尔定律在 IoT 上的体现。

    3. Apollo3 Blue vs Apollo4 / Apollo510

    SoC 工艺 频率 功耗 量产状态
    Apollo3 Blue 40 nm 48 / 96 MHz 6 μA/MHz 量产生
    Apollo4 / Apollo4 Plus 40 nm 96 / 192 MHz 4 μA/MHz 主流出货
    Apollo510 Lite 22 nm 96 / 192 MHz 更低 2026 新品

    Apollo3 Blue 是 40 nm 老工艺的”末班车”,但今天仍有新设计用它——6 μA/MHz 仍然是 Ambiq 所有 Apollo 平台里最低的(甚至比 Apollo4 的 4 μA/MHz 数字高,但 Apollo3 Blue 是旧芯片,工艺优化空间小)。

    收尾

    SparkFun Edge 已经停产 2 年,但Apollo3 Blue 仍然在被新设计采用。如果是做超低功耗语音 trigger / always-on sensing 的项目,Apollo3 Blue 仍是好选择(虽然 22 nm 工艺的 Apollo4 / Apollo510 是更现代的选项)。

    TinyML 的入门起点,从 2019 年的 Edge 走到 2026 年的 XIAO nRF54LM20A Sense——板子越来越小,模型越来越准,电池越来越耐用。

    *图片来源:SparkFun 官方 Edge / Apollo3 Blue 开发板。*
  • Nordic nRF54LM20B:首款集成 NPU 的 nRF54L

    Nordic nRF54LM20B:首款集成 NPU 的 nRF54L

    Nordic nRF54L 系列首款集成 NPU(神经网络处理单元)的 SoC:nRF54LM20B。跟 nRF54LM20A 相比,LM20B 多了 Nordic 自研的 Axon NPU,专为端侧 ML 推理加速设计。

    为什么要在 BLE 芯片里塞 NPU

    传统 Cortex-M 跑 TensorFlow Lite / ONNX 模型已经够用,但功耗和延迟是瓶颈:

    • BLE 芯片深度睡眠 1-5 μA,但 ML 推理一次要几毫安 × 几十毫秒
    • 推理一次电池就少几微安时
    • 延迟 50-100 ms 也不适合”实时响应”场景

    NPU 解决的问题:在 Cortex-M 之外,加一个专做矩阵乘法和卷积的小处理器(Cortex-M 跑不动的高强度数学,NPU 来做),让 ML 推理的能效和延迟下降一个数量级。

    关键数据

    • 15 倍速度提升(vs CPU 跑 TensorFlow Lite)
    • 8 倍能效提升(vs 竞品)
    • 7 倍速度提升(vs 竞品)
    • 推理模型大小:从几 MB 压到 5 KB(用 Nordic 的 Neuton 工具)

    5 KB 模型大小对 BLE 芯片很关键——可以常驻在 2 MB NVM 里,运行时直接调用。

    硬件结构

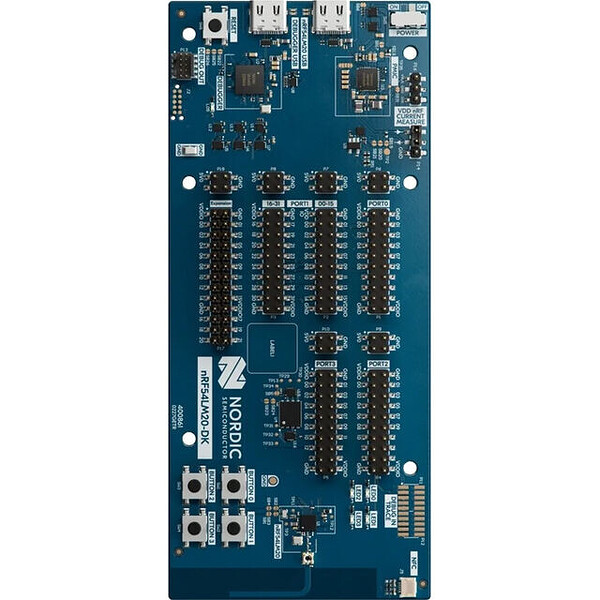
    nRF54LM20B 在 nRF54LM20A 的基础上多了 Axon NPU,其他基本一致:

    • CPU 1:128 MHz Arm Cortex-M33(应用)
    • CPU 2:128 MHz RISC-V 协处理器(外设 / 实时任务)
    • NPU:Axon(Nordic 自研)— 矩阵乘 + 卷积 + 部分 RNN
    • 内存:2 MB NVM + 512 KB RAM
    • 无线:BLE 6.0(含 Channel Sounding)/ Matter / Thread / Zigbee / NFC / 802.15.4 / 2.4 GHz 私有
    • 安全:PSA 3 级 + TrustZone + 加密加速 + 篡改检测
    • 封装:QFN-48(6×6 mm)

    适合哪些场景

    Axon NPU 的目标场景都是”端侧实时反应”:

    • 手势识别:手环 / 戒指 / AR 控制器
    • 异常检测:振动传感器 / 工业设备监控
    • 声音关键词:智能门锁 / 智能音箱
    • 生物特征:心率 / ECG / 血氧

    这些场景的共同点:事件触发 + 实时响应——要求毫秒级延迟、低功耗、模型常驻。

    几个观察

    1. nRF54LM20B vs nRF54LM20A — 唯一区别是 NPU

    nRF54LM20A 和 nRF54LM20B 是同一代产品,唯一的硬件差异是 NPU。没有 NPU 的 LM20A 也能跑 ML(用 CPU),但有 NPU 的 LM20B 跑起来快 15 倍、省电 8 倍。

    型号 用途
    nRF54LM20A 通用低功耗 BLE + 无线,不需要本地 ML
    nRF54LM20B 上面所有 + 端侧 ML 推理

    如果产品不需要本地 AI(多数信标、传感器节点、Matter 设备都不需要),LM20A 就够,省成本。需要本地 AI 才上 LM20B。

    2. 与矽递 XIAO 的关系

    矽递 Seeed Studio XIAO nRF54LM20A / Sense 是基于 nRF54LM20A 的紧凑板。未来会有 XIAO nRF54LM20B Sense(Q3 2026 末),同样小尺寸 + NPU + IMU + 麦克风 + Matter / Thread 支持。矽递确认了 XIAO nRF54LM20B 在规划中。

    3. AI 在 BLE 芯片上的”什么时候值得”

    并不是所有 IoT 设备都需要 NPU。判断标准:

    场景 需要 NPU?
    周期性上报温湿度 / 电池电压 ❌ 不需要
    BLE 配网 + Matter 协议 ❌ 不需要
    智能门锁手势识别 ✅ 需要(实时、低延迟)
    工业振动异常检测 ✅ 需要(频谱分析、CWT)
    医疗可穿戴 ECG 实时分析 ✅ 需要(毫秒级延迟)
    智能音箱关键词唤醒 ✅ 需要(always-on、低功耗)

    NPU 不是为了”跑大模型”,而是为了”在 BLE 芯片功耗预算下跑 5 KB 模型做实时响应”。

    收尾

    nRF54LM20B 的意义不在 NPU 本身,而在于 “BLE 芯片也能做边缘 AI”。过去这件事要么做不到(用 Cortex-M 跑模型太慢太费电),要么需要外挂 AI 芯片(贵、占板、吃电)。nRF54LM20B 把这件事塞进了一颗 6×6 mm 的封装里。

    已量产。需要本地 AI 的 IoT 设备,从这里开始。

    *图片来源:Nordic 官方 nRF54LM20 DK 开发板。*

  • Ambiq Apollo330 Plus / Apollo510 Lite:AI 能效 30 倍

    Ambiq Apollo330 Plus / Apollo510 Lite:AI 能效 30 倍

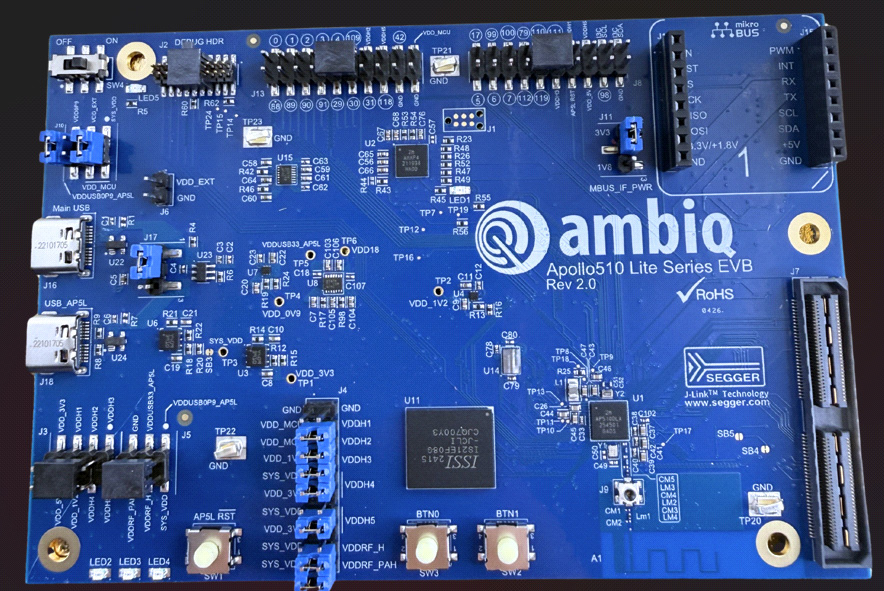
    2026 年 7 月 27 日,Ambiq 一次性发布了 6 款超低功耗 SoC:Apollo330 Plus 系列 3 款(旗舰 / 蓝牙 / 多协议) + Apollo510 Lite 系列 3 款(轻量 / 蓝牙 / 显示屏)。这是 Ambiq Apollo 平台在 Apollo4 之后最大的一次产品线更新。

    数字说话

    这 6 款新 SoC 几个关键数据:

    • 性能 +16 倍(vs 上一代 Cortex-M 平台)
    • AI 能效 +30 倍
    • 工艺:22nm(比 Apollo4 的 40nm 提升一档)
    • RTM(Release to Manufacturing,已量产)

    30 倍 AI 能效是这一代最值钱的指标。在电池供电的可穿戴 / IoT 设备上,这意味着同样电量的电池能多撑 30 倍的 AI 推理时间。

    CPU 架构

    6 款都是 Arm Cortex-M55 + Helium + turboSPOT 组合:

    • Cortex-M55:比 M4 / M33 更新的 Cortex-M 内核,主打 DSP 和 ML 加速
    • Helium:Arm 的 M-Profile Vector Extension,SIMD 加速,整数 / 浮点 / DSP 一把抓
    • turboSPOT:Ambiq 自家动态电压频率调节,按负载切换

    频率档位:

    • 标准:96 MHz
    • turbo:192 – 250 MHz(不同型号不同)

    6 款产品定位

    型号 定位
    Apollo330 Plus 旗舰(通用 + AI)
    Apollo330B Plus 蓝牙版(+ BLE 5.4)
    Apollo330M Plus 多协议版(+ 802.15.4 / Thread / Matter)
    Apollo510 Lite 轻量(低内存版本,定位入门)
    Apollo510B Lite 蓝牙版(+ BLE 5.4)
    Apollo510D Lite 显示屏版(+ MIPI DSI)

    Apollo330 Plus 面向高端可穿戴 / AR / 医疗,Apollo510 Lite 面向成本敏感的小型 IoT 设备。

    内存

    6 款都是 2 MB NVM + 2 MB SRAM。2 MB SRAM 对 Cortex-M55 这种带 Helium 的应用来说够跑中小型 ML 模型(1-2 MB 大小)。

    集成度

    Apollo330 / 510 Lite 系列把外设堆得很满:

    • MIPI DSI 1.5 Gbps(2 lanes)— 高分辨率显示
    • 2D/2.5D GPU(带 anti-aliasing、dithering、硬件矢量加速)
    • secureSPOT 3.0 + TrustZone 隔离
    • Wi-Fi 协同接口(搭配 Ambiq 的 Wi-Fi 伴侣芯片)
    • USB 2.0 Full-Speed / High-Speed
    • SDIO 3.0 / eMMC 控制器

    在 Cortex-M 这个级别,这种集成度是 Ambiq 特有的(其他 Cortex-M 厂商通常不集成 GPU 和显示接口)。

    几个观察

    1. Apollo510 Lite 名字带 “Lite” 不是低端

    Ambiq 把 “Lite” 用在 Apollo510 系列——这是 *旗舰的入门版*,不是 *低端的旗舰版*。

    对比 30 系列:Apollo510 Lite 的 CPU 主频 / 内存 / 工艺跟 Apollo330 Plus 一致(22nm、Cortex-M55、2MB+2MB)。”Lite” 主要区别在外设 + 包装——减掉 GPU / 显示屏 / 高端接口,保留核心 AI 能力。

    也就是说,Apollo510 Lite = Apollo330 Plus 砍掉贵的外设,便宜但 AI 性能不变。

    2. Ambiq 押宝 Cortex-M55 + Helium

    Cortex-M55 是 Arm 在 Cortex-M 系列里首个带 Helium(SIMD 加速)的内核。Helium 给整数 / 浮点 / DSP 指令加上 SIMD 能力,对 ML 推理特别友好。

    Ambiq 这次全系切到 M55 + Helium,直接放弃了 Cortex-M4 / M33 平台。这个选择让 Ambiq 6 款新 SoC 的 AI 性能直接超过上一代 Cortex-M 平台 16 倍。

    3. 与 Nordic nRF54LM20B 的对比

    Ambiq 和 Nordic 在低功耗 AI 这条路上走了两条不同的路:

    • Ambiq:纯低功耗 + Cortex-M 平台 + AI 加速,没有 BLE 之外的无线(要外加 Wi-Fi 伴侣芯片)
    • Nordic:低功耗 + 多协议无线 + Cortex-M + AI 加速(nRF54LM20B 加 NPU,单芯片搞定)

    Ambiq 的优势:超低功耗(4.76 μA 深度睡眠在 TinyML SoC 里仍是第一档)、显示 / GPU 集成度(其他 Cortex-M 厂商没有)
    Nordic 的优势:单芯片多协议(BLE / Thread / Matter / Zigbee / NFC 都不外挂)

    收尾

    Ambiq Apollo330 Plus / Apollo510 Lite 是一次集成度拉满的 SoC 更新——把 Cortex-M55 + Helium、2MB+2MB 内存、MIPI 显示、2D GPU、22nm 工艺、secureSPOT 3.0 全塞进一颗 6×6 mm 的封装里。

    已 RTM 量产,小米手环 9 / OPPO Watch 5 / 下一代 AirTag 类产品里大概率能看到这批芯片。

    *图片来源:Ambiq 官方 Apollo510 Lite EVB Quick Start Guide。*

  • 本周光模块 4 件大事

    本周光模块 4 件大事

    本周光模块 4 件大事

    > 本站 · 2026-10-14

    >

    > 范围:2026-10-07 至 2026-10-14

    >

    > 数据来源:公开新闻、官方公告、研究报告

    >

    > 本文仅汇总公开信息,不构成投资建议


    1. 长江证券 10 月金股推荐中际旭创

    10/11,中财网报道长江证券发布 2026 年 10 月科技行业金股组合,将中际旭创列为通信板块首选。

    报告引用的公司公开信息:

    • 800G 光模块出货量持续领跑全球
    • Q3 订单饱满
    • 北美头部云厂商采购占比超 65%
    • 800G 已规模上量,1.6T 产品明年起批量交付
    • 当前估值处于近三年中低位

    数据来源:

    • 中财网:https://cfi.net.cn/p20261011000297.html
    • 长江证券 10 月金股报告(需联系长江证券销售获取)

    2. 新易盛光博会发布 6.4T NPO + 12.8T XPO 样品

    公开报道显示,新易盛在 2026 年光博会上展出:

    • 6.4T NPO 近封装光模块
    • 12.8T XPO 超高密度液冷光模块
    • 基于 3D MEMS 技术的 OCS 光路交换机

    注:以上为公司在公开展会发布的产品规格信息,不代表已量产。

    数据来源:

    • 真灼财经:https://www.zhenzhuoglobal.com/article/112799.html

    3. OCP 全球峰会 10/12 英伟达专场

    10/12-10/14,OCP Global Summit 在美国圣何塞召开。

    议程显示 10/12 英伟达专场包括 NPO/CPO 产业化相关议题。

    注:本条仅有议程信息。英伟达具体发言内容、承诺时间表待 OCP 官方内容发布后核实。

    数据来源:

    • OCP 官方议程:https://www.opencompute.org/

    4. 全球云厂 2026 Capex 指引

    公开报道引用数据:

    • 微软、谷歌、Meta、亚马逊 4 家 2026 Capex 指引合计约 7300 亿美元
    • 同比约 +77%
    • 含 Oracle 在内 5 家合计超 8600 亿美元

    重要:以上数据来自今日头条等转载报道,未直接核对各公司原始 Capex 公告。建议读者查阅以下官方文件核实:

    • 微软 10-K (Q4 2026)
    • 谷歌母公司 Alphabet Q4 2026 财报
    • Meta Q4 2026 财报
    • 亚马逊 Q4 2026 财报

    数据来源:

    • 今日头条转载:https://www.toutiao.com/article/7693775435242504704
    • 各公司投资者关系页

    5. 智元机器人第 2 万台下线

    10/9 报道,智元机器人在珠海横琴下线第 2 万台整机。

    同日,全球首个大规模具身智能主题乐园在横琴开门迎客,数百台机器人常态化投入服务岗位。

    数据来源:

    • The Live Today(10/5):https://thelivetoday.com/?p=1073
    • 中国经济网:https://www.ce.cn/xwzx/gnsz/gdxw/202610/t20261012_3254114.shtml

    6. 优必选柳州工厂投产

    9/12 报道,优必选柳州超级智慧工厂投产。

    • 每 10 分钟下线 1 台
    • 年规划产能超万台
    • 上半年人形机器人总销量 16123 台,同比 +268.3%
    • 与一汽-大众合作扩展到工厂物流

    数据来源:

    • 中国经济网:https://www.ce.cn/xwzx/gnsz/gdxw/202610/t20261012_3254114.shtml

    7. Frost & Sullivan 2026 H1 报告关键数据

    Frost & Sullivan 9/29 发布《2026 全球人形机器人市场研究报告》:

    | 厂商 | 2026 H1 销量 | 收入市场份额 |

    |——|————-|————–|

    | 优必选 | 16123 台 | 16.5% |

    | 智元 | 7850 台 | 16.1% |

    | 宇树 | 4900 台 | 15.3% |

    | 银河通用 | 308 台 | 5.5% |

    | 乐聚 | 3540 台 | 4.0% |

    数据来源:

    • 弗若斯特沙利文报告(公开摘要)
    • 腾讯网报道:https://new.qq.com/rain/a/20261012A02R0Z00

    本周观察(作者观点)

    > 以下为作者基于公开信息的个人判断,非事实陈述:

    • 10 月底-11 月初是观察 Q3 业绩兑现的关键窗口(中际旭创、新易盛、剑桥科技等)
    • 1.6T 量产爬坡速度是 2027 年行业收入弹性的核心变量

    数据来源汇总

    1. 中财网(中际旭创金股):https://cfi.net.cn/p20261011000297.html

    2. 真灼财经(光博会):https://www.zhenzhuoglobal.com/article/112799.html

    3. OCP Global Summit:https://www.opencompute.org/

    4. The Live Today(智元):https://thelivetoday.com/?p=1073

    5. 中国经济网(具身智能):https://www.ce.cn/xwzx/gnsz/gdxw/202610/t20261012_3254114.shtml

    6. 腾讯网(Frost & Sullivan):https://new.qq.com/rain/a/20261012A02R0Z00


    免责声明

    • 本文仅汇总公开新闻与报告,不构成投资建议
    • 涉及具体公司、行业数据,读者应自行核实原始来源
    • 本周观察为作者个人观点,不代表任何机构立场
    • 公众号「本站」为个人运营,不代表任何公司观点
  • 英伟达 GTC 2024:人形机器人和 AI 核弹,一次讲透

    英伟达 GTC 2024:人形机器人和 AI 核弹,一次讲透

    重磅!英伟达刚刚发布“AI核弹”,还带来了人形机器人模型【一文回顾发布会】

    文 / 腾讯科技 苏扬 郝博阳 李海丹
    牢牢掌握算力分配权的英伟达是人工智能领域当仁不让的“炸子鸡”。
    通过为包括OpenAI、Meta等人工智能企业提供包括H200、H100、A100等不同规格的GPU,英伟达一跃成为全球市值增速最快的企业之一,也因此被外界称之为人工智能时代的”卖水人“。以至于黄仁勋和他的财务团队,会在财报中,通过直观的图表来说明英伟达对于业绩的自信。
    在向SEC提交的文件中,英伟达表示,2019年1月27日投资100美元(我们)的股票,2024年1月28日价值达到1536.28美元。而对应投资100美元标准普尔500指数和纳斯达克100指数基金,价值均在200美元以下。
    今年的GTC2024上,黄仁勋的AI“核武库”正式上新,B200将成为科技巨头们追逐的“算力明星”——它不仅会成为新的AI算力底座,也将成为英伟达市值继续攀升的业绩底座。
    作为NVIDIA Blackwell架构首款新产品,B200采用双芯片设计,晶体管数量达到2080亿个,基于Blackwell架构的B200,英伟达还提供了包括GB200、DGX GB200 NVL 72,以及基于GB200和B200打造的DGX SuperPOD超算平台。
    软件服务方面,英伟达发布了集成AI开发软件微服务系统NIM,通过直接提供多行业、多模态的专有模型,以及基于NeMo Retriver的专有数据注入系统,企业可借由NIM快捷部署公司级专有模型。
    除了通过软硬件赋能AI技术之外,英伟达也推出了加速AI仿生机器人落地的解决方案——GR00T机器人项目——世界首款人形机器人模型,支持通过语言、视频和人类演示,为机器人的生成行动指令。
    以下为核心要点:
    ● B200芯片:采用双芯片设计,晶体管数量达到2080亿个。单GPU AI性能达20 PFLOPS(即每秒2万万亿次)。内存192GB,基于第五代NVLink,带宽达到1.8TB/s。
    ● DGX GB200 NVL 72:内置36颗GRACE CPU和72颗Blackwell架构GPU,AI训练性能可达720PFLOPs(即每秒72万万亿次),推理性能为1440PFLOPs(每秒144万万亿次)。
    ● 基于GB200的DGX SuperPOD超算:搭载8颗DGX GB200,即288颗Grace CPU和576颗B200 GPU,内存达到240TB,FP4精度计算性能达到11.5EFLOPs(每秒11.5百亿亿次)
    ● Project GR00T:人型机器人项目——包含了人型机器人基础模型,ISAAC Lab开发工具库和Jetson Thor SoC片上系统开发硬件,带宽达到100GB/s,AI计算性能达到800TFLOPs。
    ● NIM软件:针对AI推理系统的新软件,开发人员可以在其中直接选择模型来构建利用自己数据的人工智能应用程序。

    算力核弹B200

    英伟达最近几代架构,在名称上都有致敬科学家的惯例。
    上一代产品Hopper架构则是致敬格蕾丝·霍珀,这一代架构Blackwel则是致敬的是统计学家兼数学家大卫·布莱克韦威尔。
    在新一代的GPU正式亮相之前,关于架构、双芯片设计等已经有不少传闻,关注点在于,黄仁勋会把手中的“AI核弹”性能提升到多少?
    现在,官方的答案给出来了——基于Blackwell架构的B200采用双芯片设计,基于台积电4nm工艺,晶体管数量达到2080亿个,上一代Hopper架构的H100同样是4nm工艺,但由于没有上双芯片设计,晶体管数量只有800亿。
    B200搭配8颗HBM3e内存(比Hopper架构的H200多了2颗),内存达到192GB,基于第五代NVLink,带宽达到1.8TB/s,相比Hopper架构和Ampere架构,有了巨幅提升,最大可支持10万亿参数的模型的训练。
    作为对比,OpenAI 的 GPT-3 由 1750 亿个参数组成,GPT-4参数为1.8万亿。
    黄仁勋还介绍称,B200平台可以向下兼容,支持与上一代Hopper架构的H100/H200 HGX系统硬件适配。
    此前,被称之为OpenAI劲敌的Inflection AI,官宣建立了一套22000颗英伟达H100 GPU的世界最大人工智能数据中心集群,接下来要看看OpenAI,能不能借助B200反超了。
    这里再插一句英伟达的NVLink和NVLink Switch技术。
    其中NVLink是英伟达开发的CPU和GPU之间高速互联通道,在内存墙无法突破的情况下,最大化提升CPU和GPU之间通信的效率,于2016年在基于Pascal架构的GP100芯片和P100运算卡上率先采用,当时的带宽为160GB/s,到H100采用的第四代NVLink,其带宽已经达到900GB/s,而B200采用的第五代NVLink 带宽已经突破1.8TB/s。
    NVLink Switch支持与多个NVLink连接,实现NVLink在单节点、节点之间互联,进而创建更高带宽的GPU集群,基于最新的NVLink Switch芯片(台积电4nm工艺,500亿个晶体管),可实现576颗GPU组成计算集群,上一代产品仅支持到256个GPU。
    根据官方公布的数据,B200支持第二代Transformer引擎,Tensor核支持FP4、FP6精度计算,单颗B200 GPU的AI性能达20 PFLOPs(即每秒2亿亿次)。
    另外,英伟达还在主题演讲中展示了全新的加速计算平台DGX GB200 NVL 72,拥有9个机架,总共搭载18个GB200加速卡,即36颗GRACE CPU和72颗Blackwell架构GPU(英伟达也提供了HGX B200版本,简单来说就是用Intel的Xeon CPU,替换了Grace CPU)。
    黄仁勋说,一套DGX版GB200 NVL 72总共内置了5000条NVLink铜制线缆,总长度达到2公里,可以减少20kW的计算能耗。
    举个例子,8000个GPU组成的GH100系统,90天内可以训练一个1.8万亿参数的GPT-Moe模型,功耗15兆瓦,而使用一套2000颗GPU的GB200 NVL72加速卡,只需要4兆瓦。
    据介绍,DGX版GB200  NVL 72加速计算平台AI训练性能(FP8精度计算)可达720PFLOPs(即每秒72亿亿次),FP4精度推理性能为1440PFLOPs(每秒144亿亿次)。官方称GB200的推理性能在Hopper平台的基础上提升6倍,尤其是采用相同数量的GPU,在万亿参数Moe模型上进行基准测试,GB200的性能是Hopper平台的30倍。
    演讲环节,黄仁勋还公布了搭载64个800Gb/s端口、且配备RoCE自适应路由的NVIDIA Quantum-X800 InfiniBand 交换机,以及搭载144个800Gb/s端口,网络内计算性能达到14.4TFLOPs(每秒14.4万亿次)的Spectrum-X800交换机。两者应对的客户需求群体略有差异,如果追求超大规模、高性能可采用NVLink+InfiniBand网络;如果是多租户、工作负载多样性,需融入生成式AI,则用高性能Spectrum-X以太网架构。
    另外,英伟达还推出了基于GB200的DGX Super Pod一站式AI超算解决方案,采用高效液冷机架,搭载8套DGX GB200系统,即288颗Grace CPU和576颗B200 GPU,内存达到240TB,FP4精度计算性能达到11.5ELOPs(每秒11.5百亿亿次),相比上一代产品的推理性能提升30倍,训练性能提升4倍。
    黄仁勋说,如果你想获得更多的性能,也不是不可以——发挥钞能力——在DGX Super Pod中整合更多的机架,搭载更多的DGX GB200加速卡。

    NIM+NeMo:构建英伟达版企业用GPTs

    英伟达的另一个杀手锏就是它的软件,它构成了这一万亿帝国至少半条护城河。
    诞生于2006年的CUDA被认为是英伟达在GPU上建立霸权的关键功臣——它使得GPU从调用 GPU计算和GPU硬件加速第一次成为可能,让 GPU 拥有了解决复杂计算问题的能力。在它的加持下,GPU从图形处理器这一单一功能发展成了通用的并行算力设备,也因此AI的开发才有可能。
    但谈论 NVIDIA时,许多人都倾向于使用“CUDA”作为 NVIDIA提供的所有软件的简写。这是一种误导,因为 NVIDIA的软件护城河不仅仅是 CUDA 开发层,还包含了其上的一系列连通软硬件的软件程序,比如英伟达开发的用于运行C++推理框架,去兼容Pytorch等模型训练框架的TensorRT;使团队能够部署来自多个深度学习和机器学习框架的任何 AI 模型的 Triton Inference Server。
    虽然有如此丰富的软件生态,但对于缺乏AI基础开发能力的传统行业来讲,这些分散的系统还是太难掌握。
    看准了这个给传统企业赋能的赛道,在今天的发布会上,英伟达推出了集成过去几年所做的所有软件于一起的新的容器型微服务:NVIDIA NIM。它集成到了不给中间商活路的地步,可以让传统企业直接简单部署完全利用自己数据的专属行业模型。
    这一软件提供了一个从最浅层的应用软件到最深层的硬件编程体系CUDA的直接通路。构成 GenAI 应用程序的各种组件(模型、RAG、数据等)都可以完成直达NVIDIA GPU的全链路优化。
    它让缺乏AI开发经验的传统行业可以通过在 NVIDIA 的安装基础上运行的经过打包和优化的预训练模型,一步到位部署AI应用,直接享受到英伟达GPU带来的最优部署时效,绕过AI开发公司或者模型公司部署调优的成本。Nvidia 企业计算副总裁 Manuvir Das表示,不久前,需要数据科学家来构建和部署这些类型的 GenAI 应用程序。但有了 NIM,任何开发人员现在都可以构建聊天机器人之类的东西并将其部署给客户。
    这一切都建立在Kubernetes这一容器化应用程序之上。NVIDIA通过Kubernetes创建了一个单一的架构,可以运行所有这些软件。NIM作为预构建的容器(containers),开发人员可以在其中直接选择模型来构建利用自己数据的人工智能应用程序。在容器中配备了适用于语言和药物发现等人工智能领域的行业标准应用程序编程接口以适应各类专有模型。
    英伟达在博客文章中表示:“NIM 针对每个模型和硬件设置利用优化的推理引擎,在加速基础设施上提供最佳的延迟和吞吐量。” “除了支持优化的社区模型之外,开发人员还可以通过使用永远不会离开数据中心边界的专有数据源来调整和微调模型,从而获得更高的准确性和性能。”
    在模型支持方面,NIM 微服务的可选项也很多。它支持 Nvidia 自己的模型合作库,来自 AI21 Labs,Cohere等合作伙伴的模型,以及来自Meta、Hugging Face、Stability AI 和Google的开源模型。同时客户可以通过 Nvidia AI Enterprise 平台以及 Microsoft Azure AI、Google Cloud Vertex AI、Google Kubernetes Engine 和 Amazon SageMaker 访问 NIM 微服务,并与包括 LangChain、LlamaIndex 和 Deepset 在内的 AI 框架集成。这基本上就等于对所有市面上主流模型都完成了覆盖。
    在Nim的搭建过程中,利用Nvidia NeMo Retriever技术,公司的专有数据都可以被集成到这个微服务里以供使用。最终用户会得到一个个NVIDIA NeMo,这就是针对每个公司的专有Copilit。这个专有的NeMo会用对话机器人的形式帮助你检索公司数据,如PPT,提供相关领域的技术支持。
    在发布会上,黄仁勋就展示了基于英伟达数据(Event)和芯片行业信息形成的Nvidia ChipNeMo,它构建在开源的Llama2模型之上。利用英伟达的专有数据,它可以回答只有英伟达公司内部使用的CTL实验细节问题。
    这些NeMo还可以跨公司共用,也就是这套系统可以被视为工业大模型的GPT Store,行业公司可以使用其他公司或英伟达提供的行业基础NeMo添加自己的数据即可获得专有大模型。为此,英伟达还特意上线了ai.nvidia.com去承载这些NeMO。
    这一微服务使得传统企业AI转型变得极为易得,不论是构筑专有模型,还是直接通过模型连接企业私有数据都变得快速方便。黄仁勋表示 “成熟的企业平台坐拥数据金矿, 他们掌握了大量可以转化为副驾驶的数据,当你准备好运行这些人工智能聊天机器人时,你将需要一个人工智能铸造厂”。NIM正是这样一个铸造厂。它帮助构建企业AI转型的Copilot级产品,可以被视为公司AI化所需的基石。
    这一产品将首先在即将发布的NVIDIA AI企业版第五版中搭载。对于NVIDIA AI企业版的现有客户来说这只是一个软件升级。这项新功能不会额外收费。当然企业版价格本身并不低,单GPU的企业版使用权限包年就需要4500美金,小时租金为1美金每小时。
    目前英伟达全公司已经都用上了Nim,包括Box、Cloudera、Cohesity、Datastax、Dropbox等合作伙伴也都已经参与Nim的使用和优化过程。

    Project GR00T机器人

    英伟达的上一个万亿市值来自GPU与算力,下一个万亿市值增幅空间可能体现在对机器人开发的赋能上。
    年初,英伟达资深科学家Jim Fan就宣布建立GEAR工作室,相关研究成果以及研究基础环境成为了英伟达新机器人解决方案的基础。
    据了解,英伟达目前正在构建包括NVIDIA IAI、Omniverse、ISAAC三大平台,三大平台均与机器人产业高度关联。其中NVIDIA IAI搭载DGX系列产品,用于模拟物理世界,Omnivese搭载RTX和OVX系列产品,用于驱动数字孪生的计算系统,ISAAC搭载AGX系列,用于驱动人工智能机器人。
    本次GTC大会上,英伟达还推出了Project GR00T人型机器人项目——人型机器人基础模型。
    英伟达表示,基于GR00T人型机器人基础模型,可以实现通过语言、视频和人类演示,来理解自然语言,模仿人类动作,进而快速学习协调性、灵活性以及其他的技能,进而能够融入现实世界并与人类进行互动。
    除了基础模型,该项目还包括基于NVIDIA Thor SoC系统的开发套件Jetson Thor,内置了下一代Blackwell GPU(此前英伟达也推出个针对汽车的DRIVE Thor套件),带宽达到100GB/s,AI计算性能达到800TFLOPs。
    为了给Project GR00T项目提供软件支持,基于英伟达Omniverse构建的ISAAC Lab也进行了同步更新,允许开发者利用该平台模拟机器人学习技能、与物理世界模拟互动,支持数千个机器人同步训练与模拟。
    与此同时,ISAAC Lab还整合了用于辅助提升机械臂的灵敏度与精确度的加速库平台ISAAC MANIPULATOR,以及用于提升服务机器人感知能力的ISAAC PERCEPTOR软件库。
    按照惯例,英伟达也不免俗的用了客户的例子为自家解决方案背书——比亚迪仓库机器人。
    黄仁勋表示,英伟达过去和比亚迪基于Omniverse构建汽车和工厂数字孪生上有了良好的合作,当然也还包括汽车自动驾驶业务方面的合作,现在则开始基于英伟达的ISSAC,展开仓库自动机器人研发方面的合作。
    在英伟达的愿景当中,未来Omniverse将成为机器人系统的诞生地和AI的虚拟训练场,你可以将其理解为“机器人产房”、“AI驾校”。

    气象观测、计算光刻与6G

     
    Omniverse的模拟不仅仅体现在机器人、数字孪生领域,在一些新技术的研发上,比如代表未来通信的6G技术研发也将派上用场。
    根据官方公布的信息,英伟达将推出6G研究云平台,其中包括为开发人员提供神经无线电仿真框架能力的NVIDIA Aerial,以及提供模拟城市规模网络的Omniverse数字孪生系统,以及提供加速的无线接入网络堆栈,从系统层面为开发者模拟一个具有城市规模的6G网络系统。
    除了6G研究,英伟达希望将Omniverse带到气候和天气预测方面。
    官方表示,极端事件每年为全球带来了1400亿美元的经济损失,而目前高性价比的气候模拟高度不能满足需求,虽然千米级的模拟可以帮助人类模拟预测气候和天气,但这个计算量相比高空模拟要超出100万倍,进而成本高昂。
    为此,英伟达公布了地球气候数字孪生套件NVIDIA Earth 2,它具有可交互的特点,支持通过高分辨率模拟来加速气候、天气预测。作为一个支持千米级天气预测的AI扩散模型,Earth 2在天气预报的计算预测上效率提升达到1000倍,而能效则提升了2000倍。
    GTC2023大会上,英伟达推出计算光刻CuLitho软件库,按照当初的设想,单就晶圆厂部分的提效即可以实现,每天利用1/9的电力,生产3-5倍的光掩膜,今年的大会上,黄仁勋也补充了计算光刻CuLitho的进展。
    官方表示,过去12个月内与TSMC和Synopsys紧密合作,已经将CuLitho集成这些客户的工作流当中,包括芯片的设计工具和生产制造。
    https://mp.weixin.qq.com/s/CKv0u1iqD8Eu_na0Cv9Y-Q
    重磅!英伟达刚刚发布“AI核弹”,还带来了人形机器人模型【一文回顾发布会】 (qq.com)

  • Sam Altman 创业手册:YC 创始人的 13 条忠告

    Sam Altman 创业手册:YC 创始人的 13 条忠告

    推荐:《Sam Altman的创业手册》

    一份由 Sam Altman 写的创业手册,从有想法到执行的全过程。

    手册原始网页:http://t.cn/E5ToU51
    翻译版1:http://t.cn/A6NGlqiQ ​​​

    Sam Altman的创业手册 – 飞书云文档 (feishu.cn)

    翻译版2:http://t.cn/A6YFNAkj

    创业指南 [译] | 宝玉的分享 (baoyu.io)

  • Claude 3 Opus 整理字幕:6 个 prompt 模板

    Claude 3 Opus 整理字幕:6 个 prompt 模板

    分享一点利用 Claude 3 Opus 整理字幕文稿的经验,它可以非常好的将文稿整理成对话形式,并且还可以按照话题分成章节!几个要点:
    1. 说明对话的人物(基本上Claude能自动分辨出哪些话是谁说的,很准)
    2. 要求根据话题分成章节(这个对于阅读、总结都很重要)
    3. 要求不要遗漏内容(不说明可能就给你总结了)

    参考 Prompt:
    “以下是我整理的 XXX 对 YYY 的采访文稿,请整理成更适合阅读的对话形式,根据话题形成章节,包含人名,尊照原意的情况下适当润色,从头开始,不要遗漏任何内容!”

    如果没有输出完整需要不停的输入 continue 直到结束。

    如果要总结,最好等到完整文稿输出完成,然后让它基于章节来总结,这样总结出来效果最好,不容易遗漏要点。

    参考 Prompt:
    “请按照上面的章节总结上面的文稿,需要详尽不要遗漏重点!”

  • hello-algo:嵌入式 C 友好的算法入门库

    hello-algo:嵌入式 C 友好的算法入门库

    开源!面向初学者入门的嵌入式 C 语言算法库!

    \n最近我在微信技术群里面,发现了一个非常棒的开源免费算法库,话不多说,直接上链接:

    https://github.com/krahets/hello-algo
    (复制到浏览器打开,或点击【阅读原文】)

    这是一个完全开源免费的数据结构与算法入门教程,对新手初学者十分友好,各个例程支持动画图解和一键运行,并且支持 Python, C++, Java, C#, Go, Swift, JS, TS, Dart, Rust, C, Zig 等主流编程语言。

    图片

    图片

    除了可以在 Github 仓库进行访问,这个项目还支持【在线阅读】、【下载 PDF】、【纸质书本】这几种方式进行学习。

    (点击【阅读原文】,立即跳转到在线阅读模式)

    这个项目已经在 GitHub 斩获了 70.1K Star 和 8.7K Fork ,并且项目还在持续更新,同时吸引了一大批开源社区里面非常优秀的开发者参与撰稿,鼓励各位读者在线上评论区互帮互助,共同进步。
    如果你是算法初学者,从未接触过算法,或者已经有一些刷题经验,对数据结构与算法有模糊的认识,在会与不会之间反复横跳,那么这个开源项目正是为你量身定制的!

    如果你已经积累一定的刷题量,熟悉大部分题型,那么这个开源项目可助你回顾和梳理算法知识体系,仓库源代码可以当作“刷题工具库”或“算法字典”来使用。

    如果你是算法“大神”,这个项目期待收到你的宝贵建议,或者一起参与创作。

    图片

    为什么数据结构和算法会如此重要,为什么很多大厂在面试的时候都喜欢手撕数据结构和算法,答案在视频里面!

  • 李开复 AI 2.0 演讲:3 个不投的赛道

    李开复 AI 2.0 演讲:3 个不投的赛道

    李开复最新演讲:AI2.0时代来临,我们不会投资移动APP 简单加上 AI 能力的公司

    \n腾讯科技讯 2024年3月18日,澜舟科技在北京举行了大模型技术和产品的发布会。作为创新工场孵化的企业之一,澜舟科技在其成长过程中获得了创新工场的多轮投资支持。在此次发布会上,创新工场的董事长兼首席执行官李开复博士发表了题为《AI 2.0:平台变革进行时》的主旨演讲。

    在演讲中,李开复讨论了AI 2.0时代的转变,AI 2.0已经能够通过图灵测试,其智能水平是人类的两三倍。当达到这一水平时,它将赋能所有应用,并带来平台级的变革。这个变革将包含三个关键步骤:强大的底层技术、开发者工具和API、最终还将促成一个全新的应用生态系统。

    演讲中也提到了AI first应用,李开复相信,真正的AI应用应该是,如果去掉大模型,整个应用就无法成立、无法工作、不存在。而自己也绝对不会投资移动互联网时代的 APP 简单加上 AI 能力的公司。

    李开复预测,AI将从虚拟设计世界走向真实世界。未来十年,AI将无处不在,并对人类所有的工作和任务带来翻天覆地的改变。

    以下为李开复演讲全文:

    在大模型时代,我们观察到了一些特别巨大的机遇。从这张图表中,我们可以看一下人工智能智商水平的发展。业界有一个名为MML6的测试,它显示大约在两年前,大型模型的性能仅略高于普通人的水平,这可以被看作是一种考试。

    然而,最近全球最优秀的大模型已经接近人类平均水平的三倍。具体来说,在100个问题中,普通人平均能正确回答34题,而最优秀的AI模型能够达到90多题。这张图表来源于木头姐的一份报告,我们很荣幸地看到我们的模型被特别标注出来。
    从应用的角度来看,许多人还在探讨所谓的“杀手级应用”在哪里。实际上,这样的应用已经出现。在海外,我们已经可以看到,一些应用能够在极短的时间内达到1亿用户。例如,微信等应用需要88到30个月才能达到这一里程碑,在 AI 领域,已经有应用在短短2到6个月内就实现了这一目标。因此,杀手级应用已经存在,并且未来会越来越多。
    我预测,三年后我们重读这张图表时,上面将全部是AIGC的应用。纯移动时代的应用将成为过去,就像移动时代的到来使得PC时代的大应用迅速成为历史一样。在这个巨大的机遇中,我们看到了人工智能带来的机遇,它就像是移动互联网赋予我们的能力:随身携带的设备,它知道你的位置和身份,这比PC平台更为强大。
    今天,AI 2.0已经能够通过图灵测试,其智能水平是人类的两三倍。当达到这一水平时,它将赋能所有应用,并带来平台级的变革。
    我们认为这次平台级的变革将经历三个重要步骤。首先是强大的底层技术,零一万物和澜舟科技都在这一领域开展工作。其次是开发者工具和API,这也是澜舟科技的重要发展方向。最终,这将促成一个全新的应用生态系统。简单来说,就像PC时代有Windows、Office和开发者工具API,安卓时代有安卓系统和各种手机应用以及整个生态系统,AI时代也将如此。
    如果对比传统的 PC或手机软件,在AI软件时代的到来中,预示着一个巨大的变革。从左侧的图表我们可以看到,在传统的PC或手机软件中,CPU是主要的计算单元。但在大模型时代,即AI软件的时代,GPU将成为主导,而数据库、代码和操作系统等将逐渐被大模型所取代。我们知道操作系统、数据库和代码是分层的,同样地,大模型也会有基础大模型和行业大模型等不同类型的推出,形成一个生态系统。
    进一步来看,我们在手机上通常是面对网页或APP。但在AI 2.0的时代,交互将通过语言或语音来进行,这意味着从底层到最高层都会发生一个非常巨大的改变。我们认为最重要的应用是我们称之为AI first的应用。这意味着,就像手机时代带来的最大价值应用是那些只能在手机上运行并充分发挥手机功能的应用一样。
    在过去,如果像四大门户网站或搜索引擎这样的网页应用没有拥抱移动互联网,只是简单地提供一个网页或APP,那么它们就不会创造最大的价值。移动时代的标志性应用,如微信、抖音和美团滴滴,是因为没有手机就无法使用,而那些仅仅将网页加上APP的应用,最终都没有取得巨大的成功。
    在今天的大语言模型时代,AI的时代已经来临。我相信,能够创造最大价值、拥有最多用户、最快达到1亿用户的,都将是原生的AI应用。如果一个应用的核心AI能力不是必需的,那么它只是在做一个基础的、类似网页的APP,这不是真正的AI应用。真正的AI应用应该是,如果去掉大模型,整个应用就无法成立、无法工作、不存在。
    因此,在创新工场投资的所有项目都在大模型领域,都必须是AI和CNN的。如果有创业者来说,他有一个很好的移动互联网APP,想通过加入一个大模型来增强它,我们不会投资,因为这应该是每个人都应该做的事情。我们要做的是具有特色、颠覆性的,只有大模型才能运行的应用,去掉大模型就不成立的,这才是真正的AI first应用。

    我们可以看到,未来不仅仅是基于文字的应用。从左到右,你可以看到我们将会有生成不同图片和视频的应用,包括最近美国Open AI发布的Sora等,我们已经进入了一个多模态时代。因此,仅仅文本是不够的,多模态与文本同样重要。

    我们还期待AI 2.0将从给我一批文字链、多模态,到提供委派式用户体验,也就是所谓的AI助手。例如,当用户告诉AI助手他的妻子要过生日时,AI助手不仅应该提供建议,而应该直接帮助用户购买鲜花。要做到这一点,AI不仅要能够生成文字和多模态内容,还要能够执行一些动作,直接完成用户想要做的事情,就像一个非常得力的助手。

    进一步发展,AI将从虚拟设计世界走向真实世界。这里看到的例子是所谓的NLP的AI,它能够进入真实世界,捕捉真实世界的各种场景,与视频、音频和人交互,完成任务。这些应用可以在家庭、工厂等地方使用。我相信在未来十年,AI将无处不在,并对人类所有的工作和任务带来翻天覆地的改变。

    多模态机器人等将使AI深入我们每天的生活和工作。在生产力方面,AI将成为得力的助手,从左到右的每个工作都能够加分、降本、增效,当然也会取代一些工作。
    (演讲全文未经李开复本人审阅)
    李开复最新演讲:AI2.0时代来临,我们不会投资移动APP 简单加上 AI 能力的公司 (qq.com)